Science · Fondements
Construire une population, pas une collection de personas.
Imagine All The People combine plusieurs approches complémentaires : des modèles probabilistes structurés pour représenter certaines dépendances entre variables, et des méthodes d'entropie maximale pour construire ou ajuster des distributions sous contraintes statistiques.
Deux apports complémentaires, une même population synthétique.
Données statistiques
Deux apports complémentaires :
Ce schéma représente une architecture méthodologique, et non un algorithme unique exécuté à l'identique dans toutes les générations.
- 01Données de référence
Données publiques pertinentes (INSEE au niveau IRIS, données sectorielles, enquêtes nationales) et données propriétaires anonymisées lorsqu'elles existent.
- 02Contraintes
Cibles marginales et croisées, traduites en contraintes sur les fréquences attendues du modèle.
- 03Maximum Entropy Relaxation
Les contraintes de cardinalité exactes sur une population finie sont reformulées comme des contraintes sur les fréquences attendues d'une distribution. Lorsque les cibles sont compatibles, ces contraintes d'espérance sont satisfaites à l'optimum ; une formulation pénalisée permet de traiter des cibles incompatibles ou bruitées.
- 04Population
Distribution de famille exponentielle sur l'espace des configurations complètes d'attributs, ajustée par optimisation convexe. Après échantillonnage d'une population finie, les écarts empiriques aux cibles sont mesurés.
- 05Individus synthétiques
Configurations complètes d'attributs échantillonnées conjointement selon la distribution ajustée, de manière compatible avec les contraintes statistiques retenues et avec les règles structurelles éventuellement imposées.
- 06Entretiens
Entretiens qualitatifs structurés avec relance contextualisée sur les points de friction.
Modèles probabilistes structurés
Toutes les caractéristiques d'une population ne sont pas générées indépendamment. Imagine All The People utilise également des modèles probabilistes structurés, notamment des réseaux bayésiens, pour représenter explicitement certaines dépendances entre attributs.
Par exemple, la distribution d'une variable peut dépendre de l'âge, du sexe, de la région, du milieu urbain ou rural, ou d'autres caractéristiques déjà générées. Ces dépendances sont définies à partir des sources statistiques disponibles et des hypothèses explicites du modèle.
Pour un graphe acyclique de variables V₁, …, V_d, la distribution jointe peut se factoriser sous la forme suivante :
- représente le contexte de population.
- désigne les variables parentes dont dépend .
Les arêtes du graphe représentent des dépendances probabilistes utilisées pour la génération. Elles ne doivent pas être interprétées automatiquement comme des relations causales.
Maximum Entropy Relaxation.
Deux niveaux complémentaires
Les modèles probabilistes permettent de représenter les dépendances retenues entre les variables d'une population. Le cadre Maximum Entropy permet, de son côté, de construire ou d'ajuster une distribution lorsqu'elle doit également satisfaire un ensemble de contraintes statistiques, notamment des contraintes marginales ou croisées portant sur plusieurs attributs.
Cette articulation peut être formulée de manière générale à partir d'une distribution probabiliste de référence q(x). On recherche alors une distribution p(x) satisfaisant les contraintes tout en s'écartant le moins possible de cette distribution de référence :
La solution prend la forme d'une famille exponentielle :
Lorsque q est uniforme sur les configurations autorisées, cette formulation retrouve le principe classique de Maximum Entropy.
Modèle probabiliste de référence → contraintes statistiques supplémentaires → distribution ajustée par projection entropique.
Certaines générations utilisent également des calibrations, des allocations d'effectifs et des règles structurelles spécifiques.
Nous partons de données de référence, traduites en contraintes statistiques. Une distribution sur les configurations complètes d'attributs est ajustée par maximum d'entropie sous ces contraintes. Une population synthétique finie est ensuite échantillonnée dans cette distribution, puis contrôlée par mesure des écarts aux cibles.
Cas classique : référence uniformeFormulation
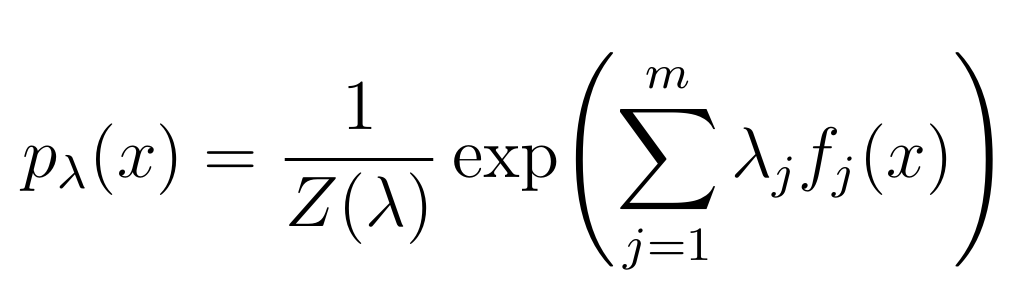
- pλ(x)probabilité d'une configuration complète d'attributs x.
- fj(x)fonction indicatrice associée au motif d'attributs j ; la contrainte porte sur son espérance Ep[fj] = αj, où αj est la fréquence cible.
- λjmultiplicateur de Lagrange associé à la contrainte j, obtenu par optimisation convexe duale dans le régime de contraintes dures.
- Z(λ)constante de normalisation de la famille exponentielle.
Parmi les distributions satisfaisant les contraintes retenues, choisir celle de maximum d'entropie : celle qui introduit le moins d'information supplémentaire au-delà de ce que les contraintes imposent.
SourceFrançois Pachet, Jean-Daniel Zucker — Maximum Entropy Relaxation of Multi-Way Cardinality Constraints for Synthetic Population Generation, Frontiers in Artificial Intelligence (évalué par les pairs · accepté pour publication) — 2026 — DOI 10.3389/frai.2026.1840945 Consulter
Principe de maximum d'entropie issu de Jaynes (1957). Côté programmation par contraintes, Régin (1996) fournit la référence classique pour le Global Cardinality Constraint sur les cardinalités unaires ; les contraintes multi-attributs sont formulées ici comme des contraintes de somme sur des motifs d'attributs.
En termes mathématiques
Imagine All The People mobilise des outils issus de plusieurs familles classiques de la modélisation statistique :
- modèles graphiques probabilistes et distributions conditionnelles pour expliciter certaines dépendances ;
- familles exponentielles pour représenter les distributions sous contraintes ;
- maximum d'entropie et minimisation de divergence de Kullback-Leibler pour ajuster une distribution de référence à de nouvelles informations statistiques ;
- calibration et contrôle des écarts sur les distributions marginales et croisées.
L'objectif n'est pas d'inférer automatiquement une structure causale, mais de construire une population probabiliste dont les hypothèses et les contraintes sont explicites et mesurables.
Respecter chaque variable n'est pas respecter leurs croisements.
Illustration conceptuelle. Une génération qui reproduit séparément chaque marginale peut néanmoins produire des croisements d'attributs très éloignés des données de référence. Les contraintes retenues portent donc aussi sur des distributions conjointes.
Une population n'est pas une moyenne.
La population conserve une diversité compatible avec les contraintes retenues : chaque individu synthétique est une configuration complète d'attributs, interrogée dans sa configuration propre et non au titre d'un profil moyen. Les typologies de lecture sont un outil d'analyse ; la simulation continue de porter sur les individus.
Illustration conceptuelle. Aucune donnée réelle n'est représentée.
De la population aux individus interrogeables.
- 01Question
Protocole d'entretien conçu pour la décision étudiée.
- 02Réponse
L'individu synthétique répond dans sa configuration propre.
- 03Relance contextualisée
Les points de friction identifiés sont creusés plutôt que contournés.
- 04Synthèse
Les insights sont restitués avec le lien vers les entretiens qui les ont produits.
Structure de population
- Données de référence
- Contraintes statistiques
- Calibration et mesure des écarts
Le LLM est une couche d'interaction
- Dialogue contextualisé de l'entretien
- Registre linguistique de l'individu interrogé
- Restitution structurée des réponses
Le modèle de langage ne détermine pas la structure statistique de la population. Celle-ci est construite et contrôlée en amont sur les attributs explicitement modélisés. Le LLM intervient ensuite pour générer les réponses conditionnellement à la configuration de chaque individu et au protocole d'entretien ; la validité comportementale de ces réponses fait l'objet d'une validation distincte.
- P(X)structure de population construite sous contraintes / MaxEnt.
- P(Y | X)réponses générées par le LLM conditionnellement aux attributs et au protocole.
- P(Y) = x P(Y | x) P(X = x)P de Y égale la somme sur x de P de Y sachant x, multiplié par P de X égal x.
Des résultats auditables ligne à ligne.
- 01Résultat restitué au client.
- 02Entretiens individuels qui l'ont produit.
- 03Population et contraintes appliquées.
- 04Données de référence et rapport de calibration.
Ce que la méthode ne prétend pas
- La population synthétique ne prédit pas une personne réelle.
- Un individu synthétique n'a pas vécu l'expérience réelle.
- Sans données de référence fiables, le résultat reste exploratoire.
- Une simulation ne remplace pas une obligation réglementaire.
- Le respect des contraintes statistiques de population ne suffit pas à établir la validité comportementale des réponses.
- Une dépendance entre attributs qui n'est pas décrite par les données, contraintes ou règles structurelles n'est pas garantie par la méthode.
Poursuivre
Les systèmes agentiques accèdent à la même infrastructure de population que les utilisateurs de la plateforme. Pour les agents IA
Votre prochaine décision
Quelle décision voulez-vous explorer ?
Décrivez votre besoin. Nous pouvons vous orienter vers le mode d’accompagnement adapté.